解字亲手构建,帮助理解
“亲手验证参与的说服力远远大于只是听讲。”
13 人明确提到获得新的知识解读;拖拽匹配让抽象关联变得可操作。
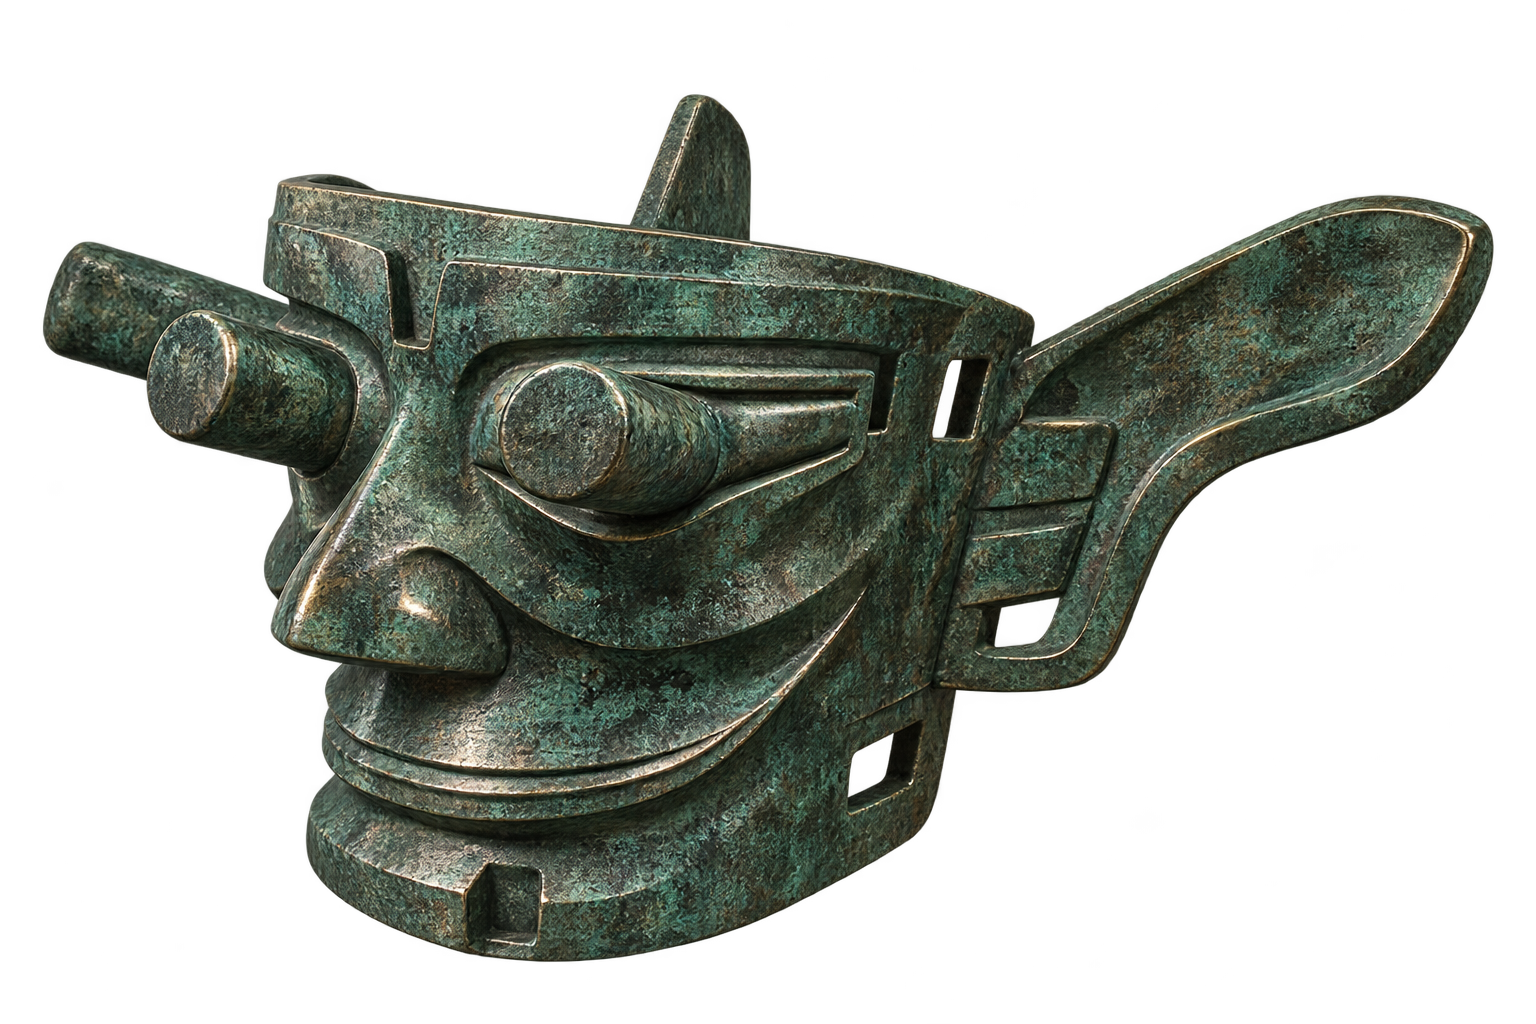
以 HoloLens 2 为目标载体,为好奇古蜀文化的参观者设计主动探索的体验。
体验呈现不同解读,文字对应与神话场景属于设计阐释。
捏合拖动字符,与眼部、耳部匹配。
亲手建立字形与器物的联系。
跟随指引靠近,站定后专注聆听。
让靠近与聆听建立仪式感。
循着面具的光束转身,注视虚拟场景。
从观看神面,到与神面共视。
单手移动字符,限制旋转,降低操作负担。
面具与字符分别建模,在场景中建立对应关系。
统一音色、空间混音与光效过渡,连接三幕体验。
礼毕后,选择重新体验或返回导览。
22 人完成三幕体验,通过前后测与回溯访谈评估认知变化。
PVS 多声部视角量表 · 1 至 5 分
+0.42量表均分变化
体验后的得分显著高于体验前,支持继续探索多视角叙事与身体参与的结合。
单组前后测,未设置对照组。结果反映本样本的即时变化,尚未验证长期保持。
21/ 22人表示对面具的解读变得更多元
另 1 人在追问字形关联时产生了更多疑问。
“亲手验证参与的说服力远远大于只是听讲。”
13 人明确提到获得新的知识解读;拖拽匹配让抽象关联变得可操作。
“好像成为祭祀的一员,心里还是突然恭敬起来。”
靠近与声景让参与者感到敬畏,身体位移连接了空间与情绪。
“从一个旁观者变成了与面具共同看向祭祀现场的经历者。”
转身后的共视,让参与者从观察器物转向代入其叙事视角。
解字的主动操作更容易留下印象。需要为聆讯与通神增加同样清晰的参与反馈,让三种解读都被充分感知。